Cerebras Systems merilis rincian arsitektur teknis mengenai cara mengeksekusi model kecerdasan buatan kelas frontier berbobot hingga 3 triliun parameter pada kluster chip seukuran wafer silikon (Wafer-Scale Engine 3, atau WSE-3T). Melalui analisis teknik yang dipublikasikan tim rekayasa perangkat keras dan kompilernya, Cerebras membongkar strategi pemetaan model raksasa Kimi K3 ke dalam 59 keping wafer untuk mencetak kecepatan inferensi antara 1.000 hingga lebih dari 2.000 token per detik.
Publikasi teknis ini menjawab tanda tanya panjang industri komputasi: bagaimana sebuah kluster silikon mampu melayani model berbobot multi-terabita ketika tiap keping wafer hanya mengantongi 44 gigabita memori SRAM bawaan. Jawabannya terletak pada perombakan mendasar jalur data, yakni mematok seluruh bobot model secara permanen di dalam keping wafer dan hanya mengalirkan nilai aktivasi antar-tahapan pipa kerja.
Dinding Memori dan Kemacetan Paralelisme Tradisional
Dalam arsitektur pusat data konvensional berbasis unit pengolah grafis (GPU) seperti Nvidia H100 atau B200, inferensi model bernilai triliunan parameter menabrak dinding fisik yang disebut *memory wall*. Bobot model yang membengkak hingga satuan terabita harus dipecah melintasi puluhan bahkan ratusan kartu akselerator menggunakan kombinasi paralelisme tensor (tensor parallelism) dan paralelisme pipa (pipeline parallelism).
Konsekuensi dari pendekatan tersebut adalah lalu lintas komunikasi lintas-kartu yang sangat bising. Setiap kali sebuah token diproses, ratusan GPU harus saling bertukar data perantara melalui interkoneksi bus seperti NVLink maupun jaringan InfiniBand. Kecepatan pembangkitan token pun akhirnya tercekik oleh latensi komunikasi jaringan eksternal dan keterbatasan bandwidth memori akses acak (HBM), yang lazimnya membatasi kecepatan inferensi model raksasa hanya pada rentang puluhan hingga seratusan token per detik per aliran pengguna.
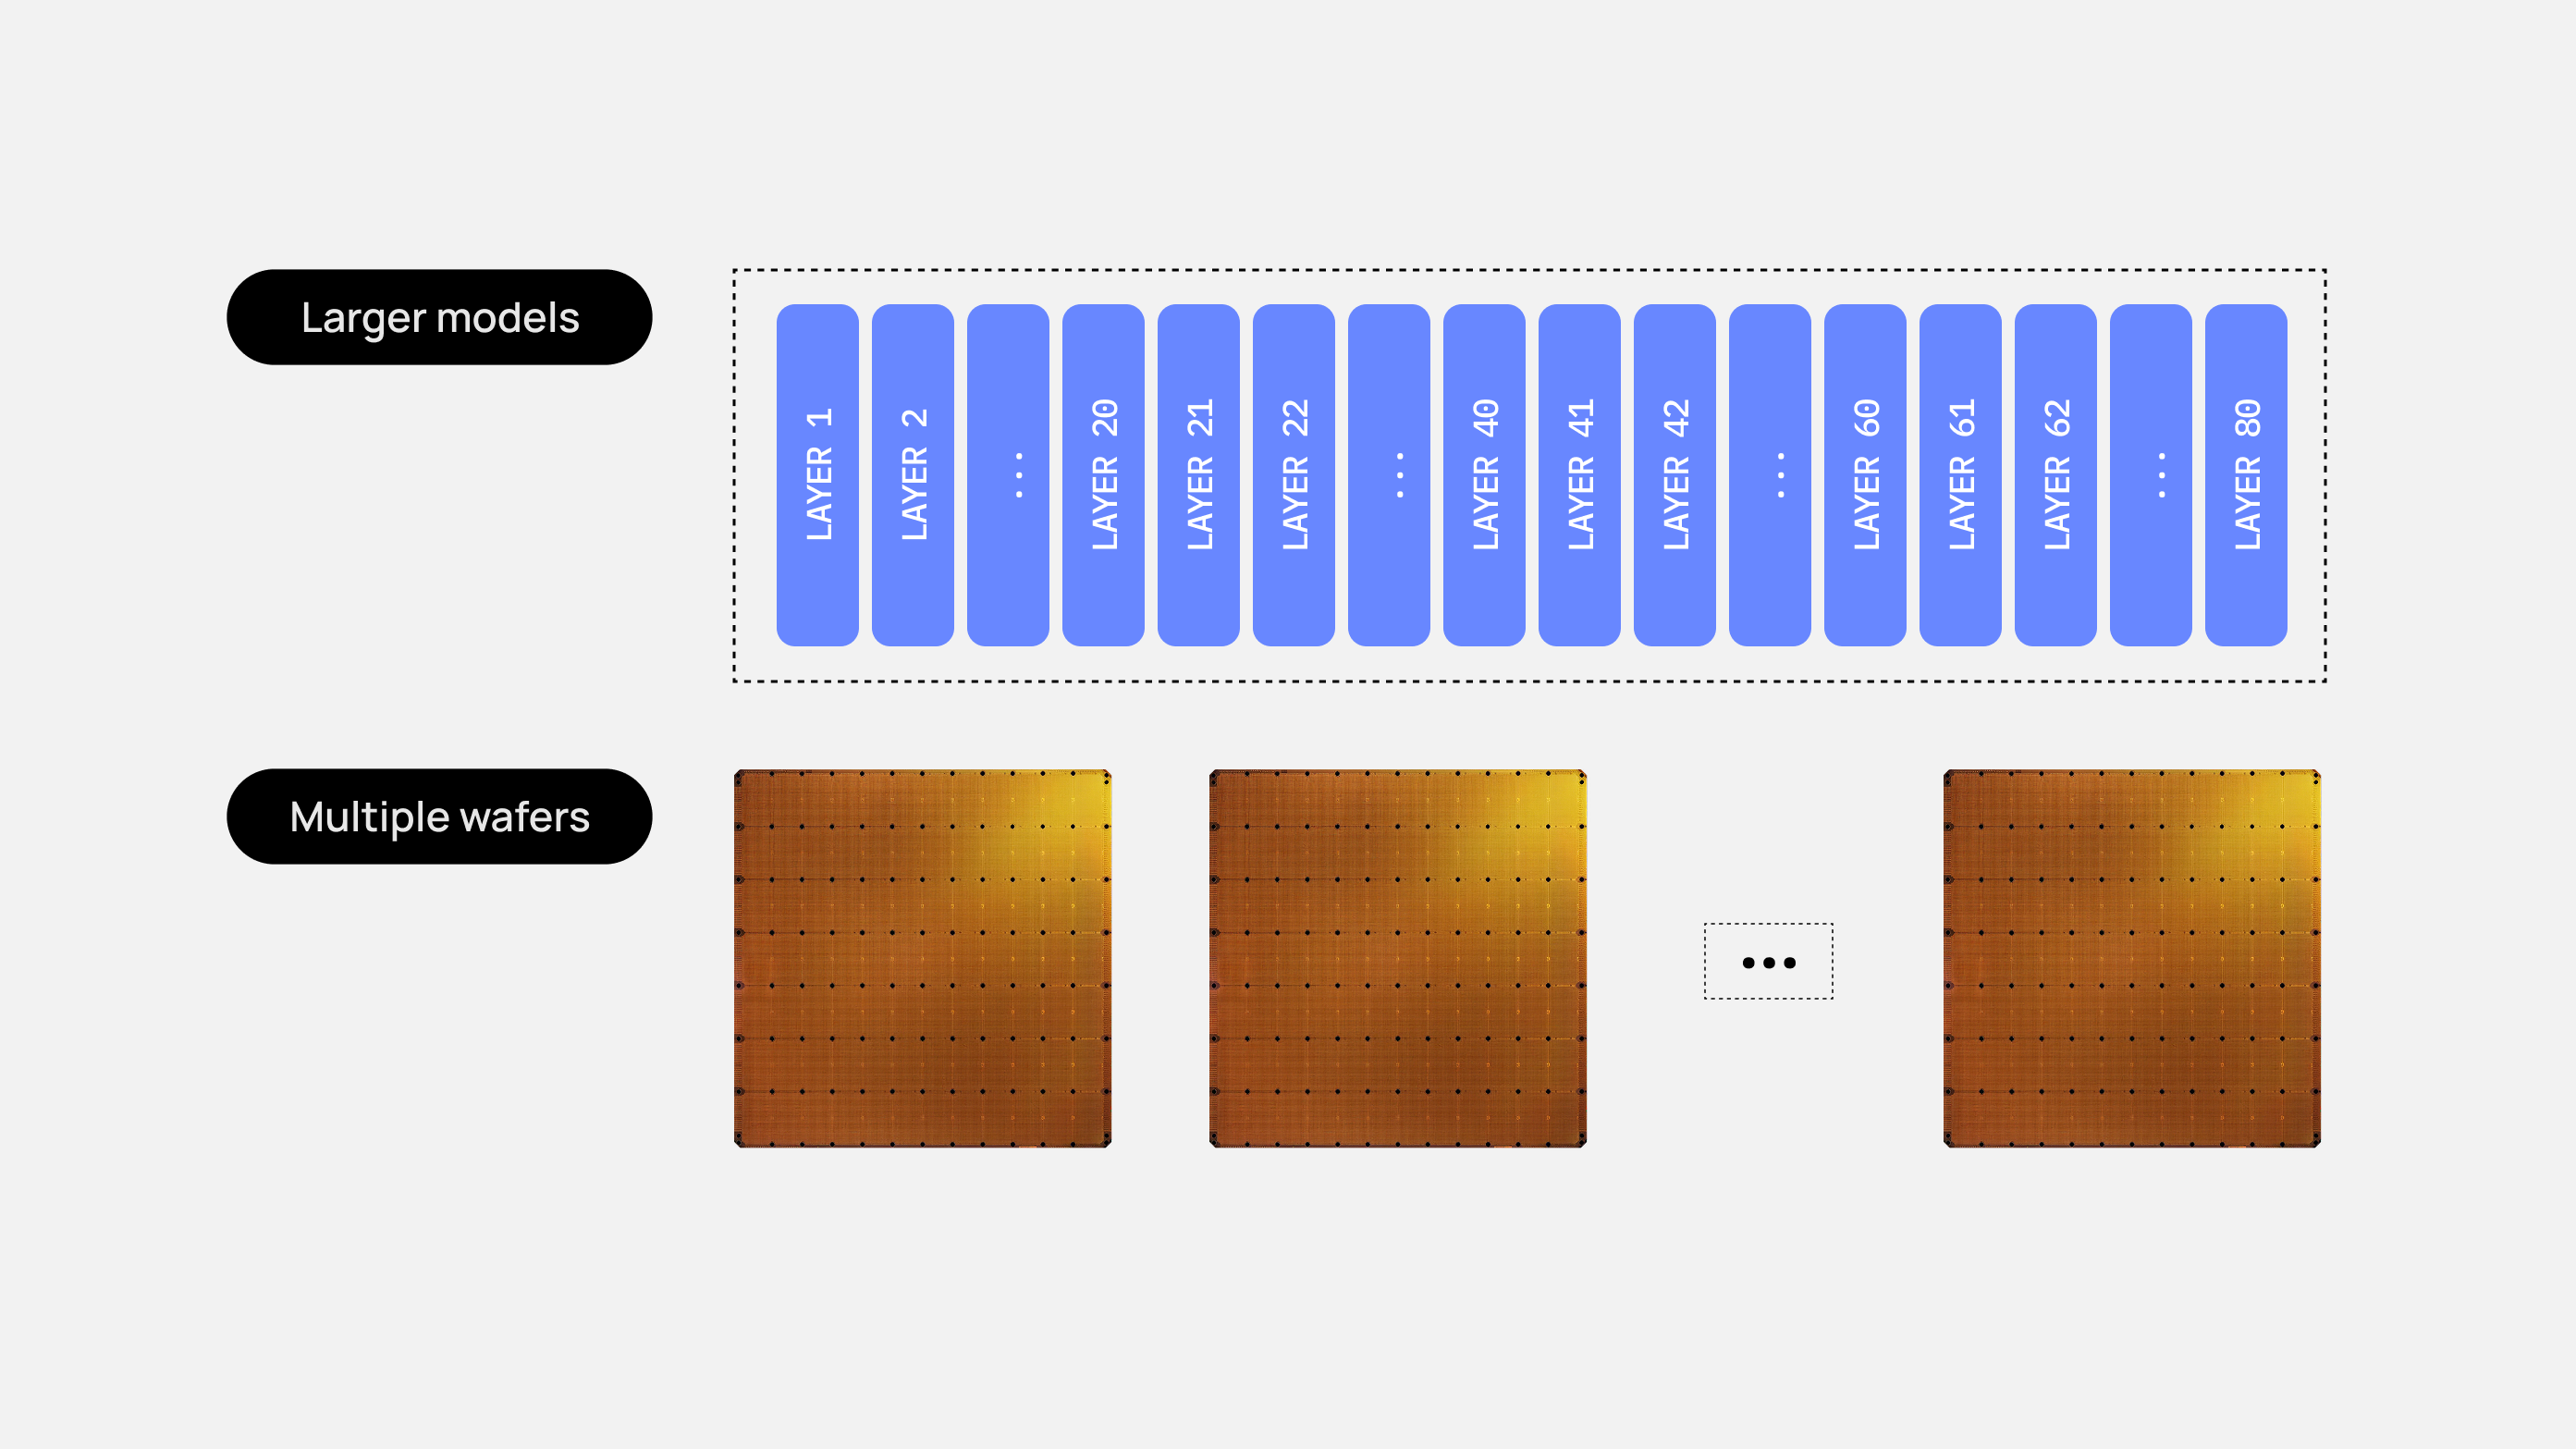
Cerebras membalik paradigma tersebut secara radikal. Alih-alih memotong matriks komputasi dalam satu lapisan ke banyak chip kecil, satu keping wafer silikon WSE-3T—yang berukuran satu piring silikon utuh dengan 900.000 inti pemrosesan AI—dialokasikan untuk memegang satu atau dua lapisan model secara utuh.
Matematika Pembagian Lapisan pada 59 Wafer
Untuk membedah arsitektur ini, tim Cerebras menggunakan model sumber terbuka Kimi K3 sebagai acuan praktis. Model ini memiliki sekitar 3 triliun parameter dengan struktur gabungan: 69 lapisan atensi linier (linear-attention layers) dan 24 lapisan atensi padat (dense-attention layers), menghasilkan total 93 lapisan hierarkis.
Dengan menerapkan kuantisasi bobot 4-bit, beban mentah seluruh parameter 3 triliun mencapai sekitar 1,5 terabita (1.500 gigabita). Jika angka tersebut dibagi rata ke 93 lapisan, setiap lapisan menuntut alokasi ruang penyimpanan bobot sebesar kira-kira 16 gigabita.
Di sinilah perbedaan sifat struktural kedua jenis lapisan atensi menentukan efisiensi perangkat keras:
Lapisan atensi padat (dense layers) membutuhkan ruang besar untuk cache Key-Value (KV cache). Setiap token baru dari pengguna aktif harus dicatat nilainya di dalam memori keping agar konteks percakapan tetap utuh. Oleh karena itu, Cerebras menempatkan tepat satu lapisan padat (16 gigabita) pada satu keping wafer 44 gigabita. Sisa ruang SRAM sebesar 28 gigabita dibiarkan bersih untuk menampung KV cache dari ratusan permintaan konkuren. Sebanyak 24 lapisan padat membutuhkan 24 keping wafer tersendiri.
Sebaliknya, lapisan atensi linier (linear-attention layers) tidak menyimpan KV cache berbasis riwayat token. Mekanisme atensi linier merangkum konteks ke dalam state berukuran tetap tanpa peduli seberapa panjang jendela teks yang dimasukkan pengguna. Karena tidak membutuhkan alokasi memori dinamis untuk KV cache, Cerebras dapat memadatkan dua lapisan linier sekaligus ke dalam satu keping wafer (2 × 16 GB = 32 gigabita, masih di bawah pagu 44 gigabita). Dengan 69 lapisan linier, kluster membutuhkan 35 keping wafer (hasil pembulatan dari 34,5).
Menggabungkan kedua kebutuhan tersebut menghasilkan total 59 keping wafer WSE-3T untuk menopang seluruh arsitektur model secara komprehensif.
Bobot Statis dan Konsep Jalur Perakitan
Setelah model dipetakan oleh kompiler khusus Cerebras, seluruh bobot 1,5 terabita dikunci ke dalam SRAM masing-masing wafer. Selama siklus inferensi berlangsung, bobot tersebut tidak pernah bergeser, dialihkan, maupun disalin ulang keluar dari keping.
Satu-satunya data yang bergerak keluar melewati jaringan adalah aktivasi perantara (intermediate activations)—hasil kalkulasi matematis dari satu tahapan lapisan yang harus diteruskan ke lapisan berikutnya. Komunikasi antar-wafer ini dieksekusi melalui protokol akses memori langsung jarak jauh (RDMA over Ethernet) dengan latensi transfer sekitar 2 mikrodetik per lompatan (hop).
Untuk mencegah keping wafer menganggur selagi menunggu giliran token melintas, sistem dioperasikan layaknya ban berjalan pada jalur perakitan pabrik manufaktur modern. Ketika Wafer 3 sedang memproses kalkulasi aktivasi untuk Permintaan A, Wafer 2 pada detik yang sama sedang menghitung aktivasi untuk Permintaan B, dan Wafer 1 menyambut token awal dari Permintaan C.
Setiap tahapan kerja dapat memproses sebuah *micro-batch*, yakni sekelompok kecil permintaan secara bersamaan. Aliran permintaan ini meluncur terus-menerus tanpa perlu saling menunggu siklus komputasi selesai seperti mekanisme batch konvensional di GPU. Hasil akhirnya adalah throughput generasi teks yang melonjak hingga 2.000 token per detik dengan latensi waktu-ke-token-pertama (TTFT) yang tetap rendah.
Konsekuensi Efisiensi dan Tolok Ukur Baru
Eksperimen arsitektur ini membuktikan bahwa batas inferensi model bahasa generasi mendatang tidak semata-mata ditentukan oleh seberapa banyak kartu akselerator yang dijejalkan ke dalam rak server. Desain sistem yang menyatukan memori dan inti pemrosesan dalam bidang silikon monolitik mampu menghapus kemacetan bus data yang selama ini membatasi kinerja kecerdasan buatan.
Cerebras menegaskan bahwa dalam mengevaluasi efisiensi infrastruktur inferensi skala raksasa, ukuran batch maupun klaim FLOPS teoritis kerap menyesatkan. Metrik yang lebih jujur untuk mengukur daya saing pusat data masa depan adalah total keluaran token per unit konsumsi energi (tokens per second per megawatt) pada kecepatan keluaran interaktif yang konstan.
Dengan semakin menjamurnya model berbobot terbuka yang menembus skala multi-triliun parameter, cetak biru 59 wafer ini memberikan gambaran konkret: inferensi instan untuk sistem penalaran tingkat tinggi dan agen otonom kini menjadi masalah rekayasa topologi jaringan dan lokalisasi memori, bukan sekadar penambahan daya komputasi mentah.
--- *Sumber:* - [Cerebras: How we deploy Trillion-parameter frontier models on Cerebras](https://www.cerebras.ai/blog/how-we-deploy-trillion-parameter-frontier-models-on-cerebras) - [Cerebras Systems: Wafer-Scale Engine Architecture Overview](https://cerebras.ai/press-release/cerebras-announces-third-generation-wafer-scale-engine) - [Moonshot AI: Kimi K3 Model Card and Architecture](https://huggingface.co/moonshotai)