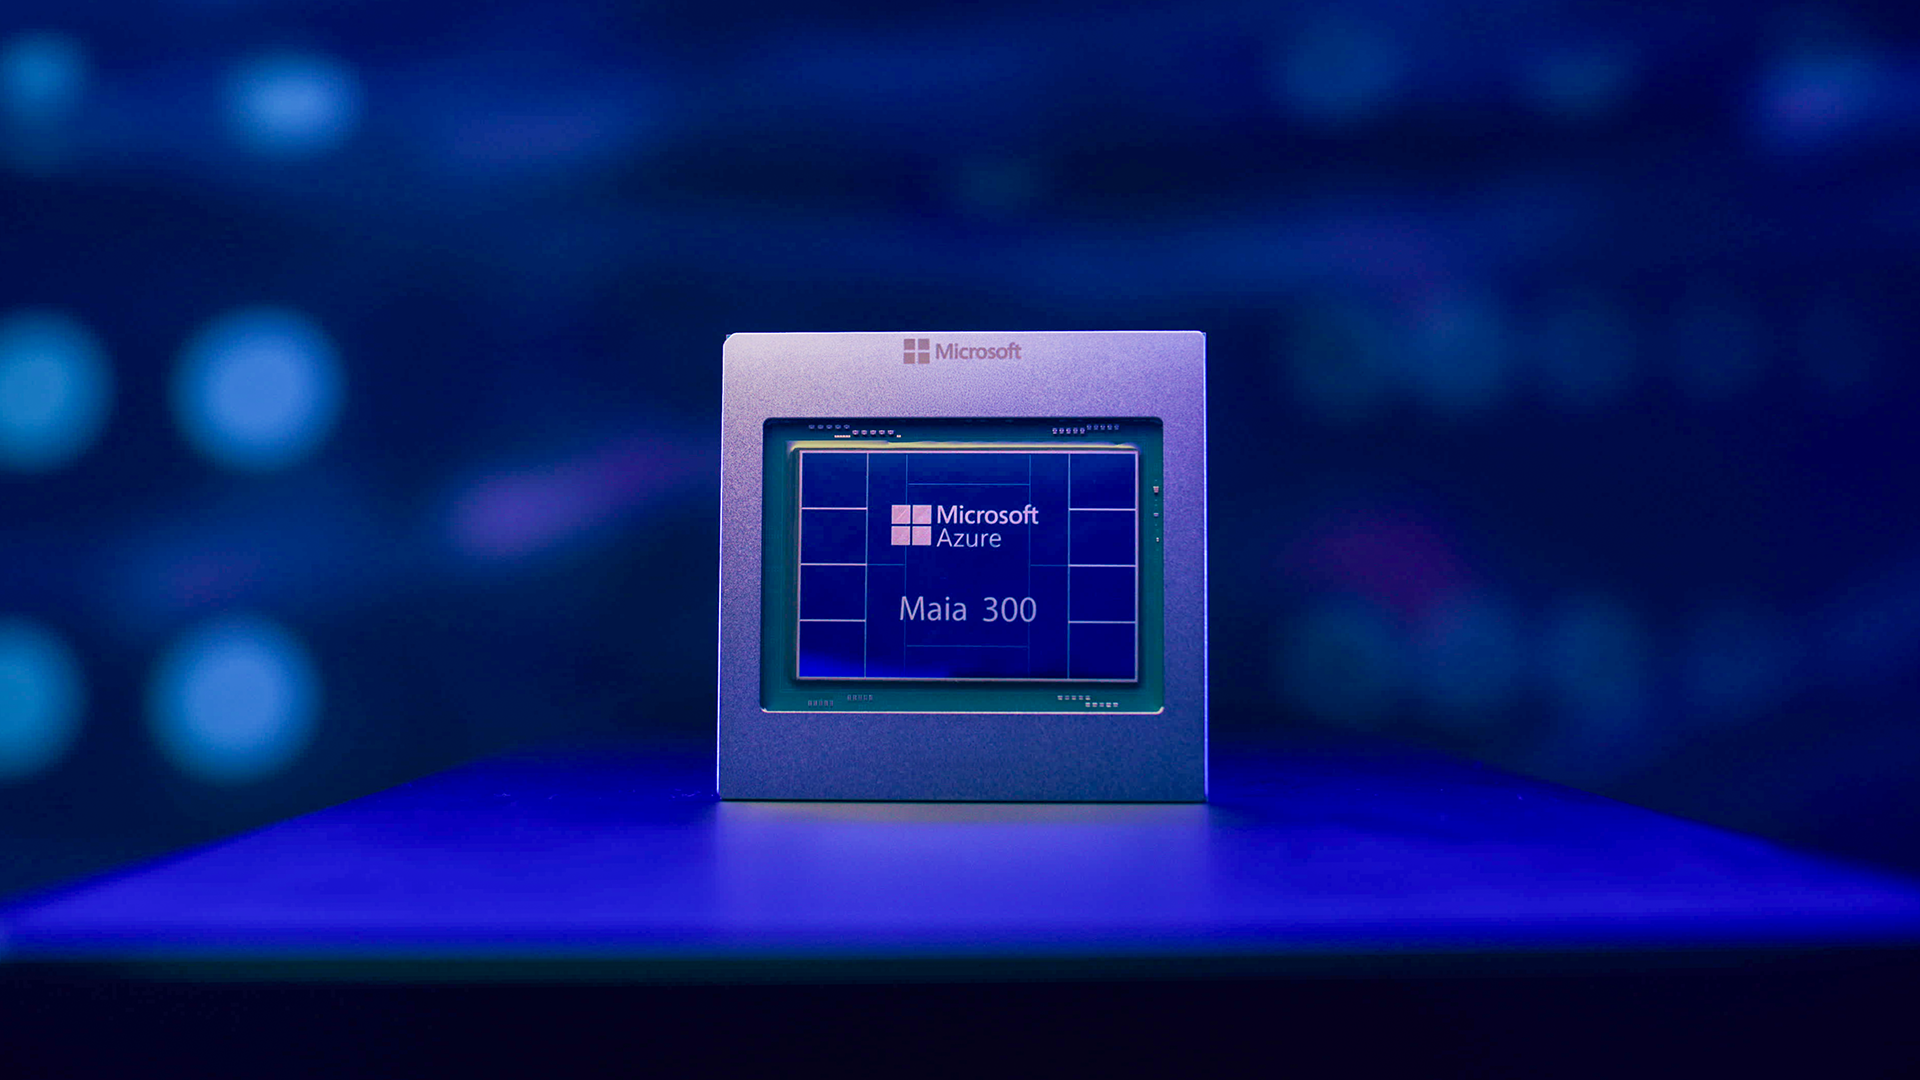
Microsoft tidak hanya memperkenalkan akselerator AI baru. Perusahaan itu sedang membangun jalur komputasi sendiri untuk menjalankan produk AI pada skala yang sangat besar. Dalam pengumuman 12 Oktober 2026, Microsoft menyatakan Azure Maia akan diperluas ke deployment multi-gigawatt mulai 2027 dan menjadi sistem inference utama untuk produk serta layanan Microsoft.
Pusat rencana itu adalah Maia 300, generasi ketiga akselerator AI buatan Microsoft. Maia 200 sudah dipakai untuk beban produksi, termasuk Microsoft Copilot. GitHub Copilot dan Microsoft Foundry disebut akan mengikuti pada akhir 2026. Maia 300 sendiri baru akan masuk deployment produksi pada 2027, jadi angka performanya masih merupakan klaim desain dan target operasional Microsoft, bukan hasil uji independen yang sudah tersedia untuk publik.
Yang dirancang bukan hanya chip
Microsoft memosisikan Maia 300 sebagai sistem lengkap. Chip, software, jaringan, rak, distribusi daya, dan pendinginan dirancang bersama untuk inference—proses menjalankan model setelah model selesai dilatih. Fokus ini berbeda dari pendekatan yang hanya mengejar jumlah operasi komputasi mentah. Untuk model dengan konteks panjang dan agen yang menjalankan banyak langkah, memindahkan data antara komputasi dan memori bisa menjadi hambatan yang sama pentingnya dengan menambah jumlah inti.
Arsitektur Maia 300 memakai pendekatan software-defined dataflow. Software mengatur penempatan, perpindahan, konversi, dan sinkronisasi data secara lebih eksplisit di antara memori lokal, mesin DMA, unit komputasi, dan jaringan. Microsoft juga memindahkan organisasi memori ke pola non-uniform memory access di antara chiplet, sehingga data dapat ditempatkan lebih dekat dengan bagian komputasi yang memakainya.
Desain multi-chiplet itu memisahkan fungsi komputasi, pengendali memori, dan I/O ke bagian yang bisa memakai teknologi proses berbeda. Microsoft mengatakan chiplet komputasinya dibuat menggunakan proses N2P milik TSMC. Di sisi inference, Maia 300 mendukung format presisi rendah seperti MXFP4 untuk mengurangi ukuran data dan bandwidth yang dibutuhkan saat model serta KV cache diproses.
Angka besar, tetapi konteksnya penting
Satu akselerator Maia 300 memiliki delapan tumpukan HBM4 dengan kapasitas 288 GB dan bandwidth puncak 18 TB per detik, menurut tulisan teknis Azure. Dalam konfigurasi rak penuh, 96 akselerator ditempatkan dalam batas daya 167 kilowatt. Totalnya mencapai 27,6 TB kapasitas HBM dan 1,7 PB per detik bandwidth HBM agregat. Microsoft mengklaim konfigurasi itu dapat menghasilkan throughput token per rak hingga tujuh kali Maia 200.
Perusahaan juga menyebut Maia 300 dapat menghasilkan 40 persen lebih banyak token per megawatt dibanding sistem GPU yang menjadi pembanding Microsoft. Klaim seperti ini harus dibaca bersama definisi workload, model, presisi, dan konfigurasi jaringan yang digunakan. Tanpa detail benchmark yang sepenuhnya dapat direproduksi, angka tersebut belum bisa dianggap sebagai peringkat umum terhadap semua GPU atau semua jenis model.
Namun arah teknisnya cukup jelas. Microsoft sedang mengoptimalkan biaya dan daya untuk inference yang terus berjalan, bukan hanya pelatihan model satu kali. Beban seperti percakapan dengan latensi rendah, konteks panjang, dan agen multi-langkah menuntut bandwidth memori besar serta komunikasi antarakselerator yang konsisten. Maia 300 menggunakan jaringan berbasis Ethernet yang dirancang sebagai bagian dari dataflow, dengan skala hingga 12.288 akselerator dalam satu superpod menurut penjelasan arsitekturnya.
Dampaknya bagi produk Microsoft
Microsoft menghubungkan Maia 300 dengan beberapa jalur produk sekaligus. Copilot dan GitHub Copilot menjadi contoh beban inference yang membutuhkan respons cepat dan volume tinggi. Microsoft Foundry membutuhkan infrastruktur yang dapat melayani model dengan arsitektur berbeda. Tim Microsoft AI juga membutuhkan kapasitas untuk inference serta pembuatan data bagi model internal. Di bidang kesehatan, Microsoft menyebut Dragon Copilot sebagai salah satu beban yang dapat memperoleh manfaat dari kapasitas dan latensi yang lebih baik.
Maia 200 memberi Microsoft kesempatan mengukur perilaku workload nyata sebelum merancang generasi berikutnya. Microsoft mengatakan Maia 200 sudah digunakan di Amerika Serikat, Eropa, dan Australia, serta memberikan hingga 1,7 kali lebih banyak token per watt untuk kemampuan AI bawaan di Teams, Copilot, dan Cowork dibanding infrastruktur GPU yang dijadikan pembanding. Klaim itu tetap berasal dari Microsoft, tetapi menunjukkan bahwa proyek Maia sudah bergerak dari eksperimen chip menuju operasi pusat data.
Yang dipertaruhkan bukan sekadar apakah Microsoft dapat membuat chip sendiri. Pertanyaan yang lebih penting adalah apakah perusahaan dapat mengoordinasikan silicon, software, model, jaringan, dan pusat data menjadi sistem yang lebih murah untuk dijalankan. Maia 300 adalah taruhan Microsoft bahwa efisiensi inference akan ditentukan oleh keseluruhan sistem—terutama data movement dan daya—bukan oleh akselerator yang berdiri sendiri.
Microsoft dijadwalkan membahas lebih banyak detail tentang strategi AI dan adopsi infrastrukturnya pada Microsoft Ignite 2026 bulan depan. Sampai deployment Maia 300 dimulai pada 2027 dan benchmark independen tersedia, bagian paling solid dari pengumuman ini adalah arah desainnya: Microsoft ingin mengontrol lebih banyak lapisan infrastruktur agar pertumbuhan produk AI tidak sepenuhnya bergantung pada pasokan akselerator pihak lain.
Sumber
- Microsoft: https://blogs.microsoft.com/blog/2026/10/12/microsoft-to-expand-azure-maia-system-to-multi-gigawatt-deployments/ - Azure Architecture: https://azure.microsoft.com/en-us/blog/deep-dive-into-azure-maia-300-architecture/ - Media asset: https://msftstories.thesourcemediaassets.com/sites/760/2026/10/Maia-300-prototype-chip-00_hero.png